
ナレッジと検索
ワークスペースのドキュメントやファイル、接続された資料をAIが検索し、それを根拠に回答やドキュメント作成を行う仕組みを説明します。
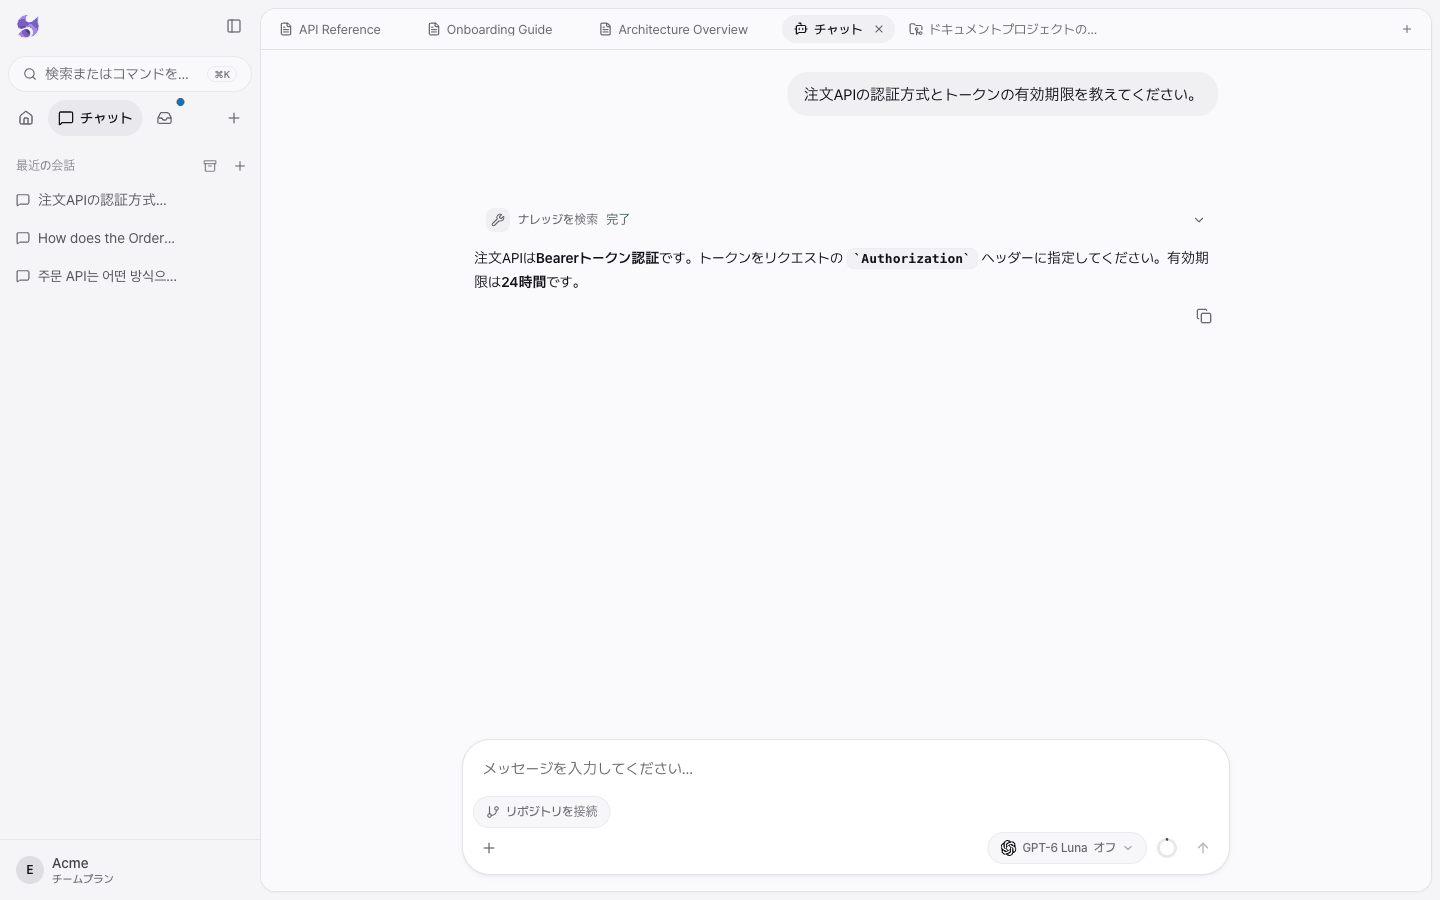
SpecifyのAIは、回答したりドキュメントを書いたりする前にワークスペースの資料を検索し、見つけた内容を根拠として使います。このように検索した資料で回答を作る方式を、RAG(Retrieval-Augmented Generation、検索拡張生成)と呼びます。特別な設定は必要ありません。ドキュメントを書き、ファイルをアップロードすれば、それがAIが探せるチームのナレッジになります。
検索の対象
| 資料 | 説明 |
|---|---|
| ワークスペースのドキュメント | エクスプローラーのテキストドキュメント。タイトルと本文がインデックス化されます。 |
| アップロードしたファイル | 外部ノードとしてアップロードしたPDF、DOCX、DOC、CSV、XLS、XLSX、TXT、MD、HTML(最大50MB) |
| Slackのメッセージ | Slackコネクターを接続した場合の、公開チャンネルのメッセージ |
| 規格文書ライブラリ | ドキュメント作成時に参照する規格の条項。規格文書ライブラリを参照してください。 |
次の資料はインデックス化されません。
- ゴミ箱に移動したドキュメントとファイル — 削除すると検索インデックスからも取り除かれ、復元すると再びインデックス化されます。
- 内容が空のドキュメント
- テキストではない項目
過去の会話とエージェントのメモリは、ドキュメントのインデックスとは別に管理されます。AIは必要に応じて、会話履歴の検索やメモリなどの別のツールで参照します。
インデックスが反映されるタイミング
ドキュメントを保存したりファイルをアップロードしたりすると、バックグラウンドでインデックス化が始まります。通常は数分以内に検索に反映されますが、大量のアップロードなどで処理が集中すると、時間がかかることがあります。アップロードしたファイルの詳細画面で、エンベディング状態を確認できます。
| 状態 | 意味 |
|---|---|
| 保留中 | インデックス化の処理を待っている |
| インデックス済み | 検索に反映された |
| 要更新 | 内容が変わったため、再びインデックス化する予定 |
| 失敗 | インデックス化できなかった。再試行を押してください。 |
| 削除中・削除済み | 削除した項目をインデックスから取り除いている・取り除かれた |
検索の仕組み
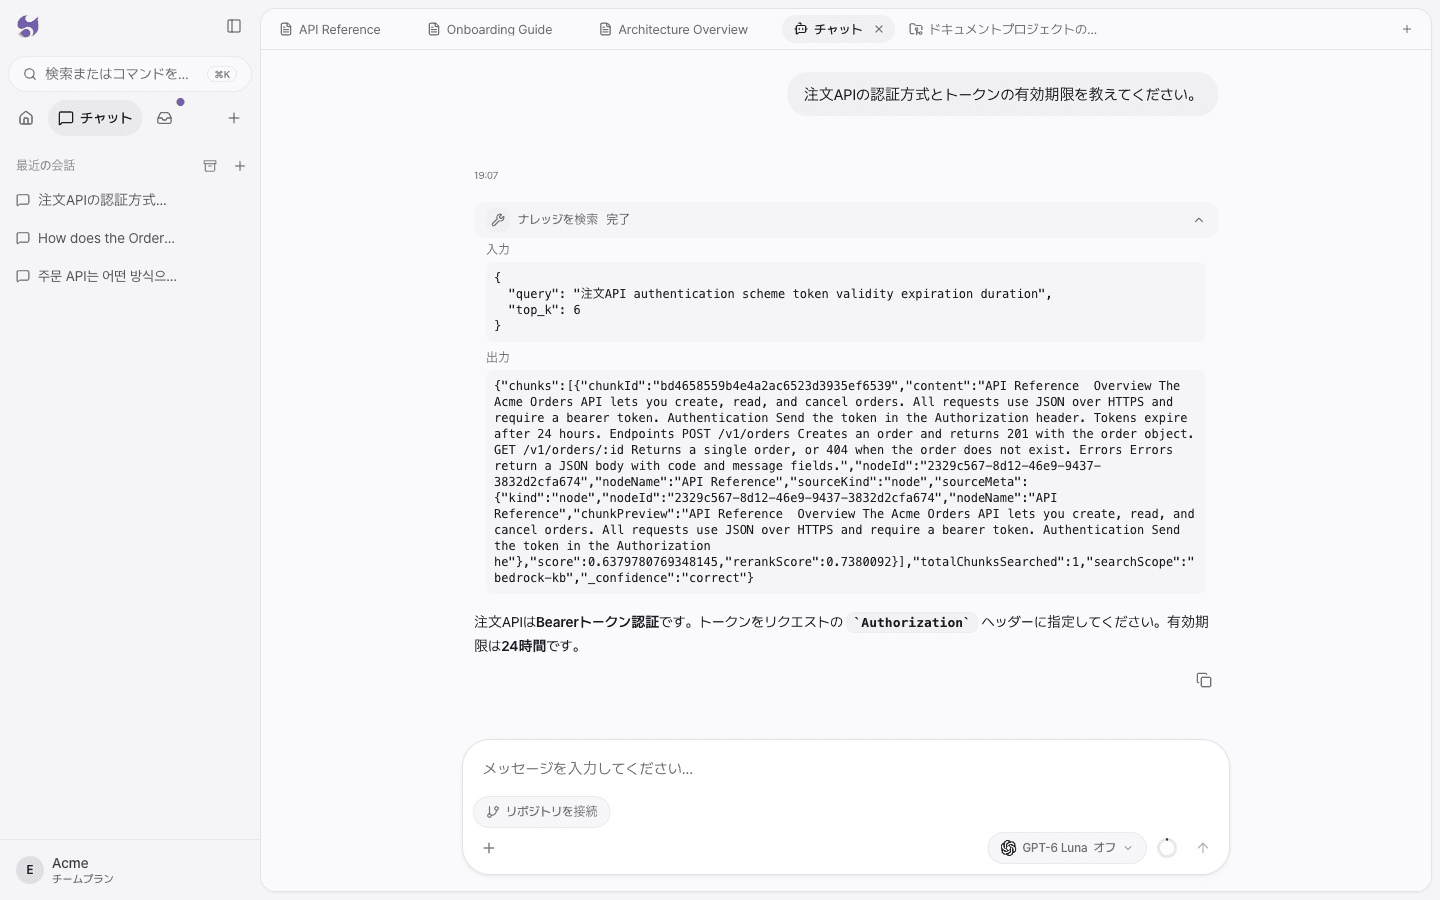
- 質問を受け取ると、AIが検索語を作成してナレッジを検索ツールに送ります。
- 検索では、ドキュメントを約300トークン単位の断片に分けたインデックスから、意味の近い断片を探します。
- 見つかった断片は関連度の順に並べ替えられ、AIに渡されます。
- AIは断片の内容を根拠に回答し、根拠となったドキュメントをリンクで示します。
チャットでナレッジを検索の行を展開すると、実際の検索語、見つかった断片、関連度のスコアを確認できます。
権限とデータの分離
- 検索は常に現在のワークスペースの中だけで行われます。別のワークスペースの資料は検索されません。
- ワークスペースのメンバーでなければ検索できません。
- コーディングエージェントがMCPの
searchツールで検索する場合も、同じワークスペースの範囲が適用されます。 - ナレッジ検索もAI予算を使用するため、予算を使い切ると検索も停止します。
ドキュメント作成での使われ方
ドキュメントプロジェクトやチャットでドキュメントを書かせると、AIはセクションごとに必要な資料を検索し、ワークスペースの実際の内容(コードの説明、意思決定の記録、既存のドキュメント)に基づいて書きます。そのため、一般論ではなく自分たちのチームの事実に合ったドキュメントができあがります。根拠が見つからない内容を作り上げないように指示されています。
検索精度を高めるコツ
- タイトルを具体的に付けます。「メモ」よりも「決済リトライの設計判断」のほうが見つかりやすくなります。
- 1つのドキュメントには1つのテーマを書きます。 複数のテーマが混ざると、断片の関連度が下がります。
- 韓国語のテキストファイルは
.mdでアップロードします。 韓国語を含む.txtは、認識に失敗することがあります。 - 質問に固有名詞を入れます。 サービス名、APIのパス、ドキュメント名を入れると、検索の精度が上がります。
- 「すべてのドキュメントを一覧にして」のような全件一覧のリクエストは、検索ではなくドキュメントの探索として処理されます。特定のテーマで質問してください。