
모델
작업 종류별로 어떤 모델과 사고 강도를 쓰면 좋은지 내부 평가 결과를 바탕으로 추천합니다.
어떤 모델을 써야 할지 모르겠다면 기본 모델인 GPT-6 Luna로 시작하세요. 문서를 쓰거나 여러 단계로 편집하는 작업, 스킬을 따라야 하는 작업이라면 Claude Sonnet 4.6을 권장합니다. 가장 어려운 분석과 긴 문서의 검증에는 Claude Opus 4.6을 씁니다.
작업별 추천
| 하려는 일 | 추천 모델 | 사고 강도 | 이유 |
|---|---|---|---|
| 팀 문서 검색, 짧은 질문, 요약 | GPT-6 Luna | 끄기 | 가장 저렴한 기본 모델입니다. 검색·조회 중심 작업은 Haiku·Sonnet 비교 평가에서도 모델 간 차이가 없었습니다. |
| 빠른 조회를 Claude로 | Claude Haiku 4.5 | 끄기 | 조회·요약·검색에서 Sonnet과 비슷한 성공률을 보였습니다. |
| 문서 새로 쓰기, 기존 문서 여러 곳 고치기 | Claude Sonnet 4.6 | 낮음~보통 | 문서 편집 작업 성공률이 Haiku보다 높습니다. |
| 스킬·플러그인 절차를 따르는 문서 작성 | Claude Sonnet 4.6 | 낮음~보통 | 스킬 적용 작업에서 가장 큰 품질 차이가 났습니다. |
| GitHub·Slack 등 커넥터를 쓰는 작업 | Claude Sonnet 4.6 | 낮음 | 커넥터 시나리오를 모두 완료했습니다. |
| 긴 문서의 구조 설계, 품질 검증, 까다로운 분석 | Claude Opus 4.6 | 보통~높음 | 가장 깊은 추론. 비용이 가장 높으니 필요한 대화에만 씁니다. |
| 같은 작업을 다른 계열 모델로 비교 | GPT-6 Sol | 보통 | Sonnet보다 저렴한 OpenAI 고성능 대안입니다. |
내부 평가 결과
Specify는 실제 워크스페이스 시나리오 38개(문서 편집, 스킬 적용, 커넥터, 메모리, RAG 검색, 여러 턴 대화 등)로 Claude Haiku 4.5와 Claude Sonnet 4.6을 비교했습니다.
| 지표 | Claude Haiku 4.5 | Claude Sonnet 4.6 |
|---|---|---|
| 작업 성공률 | 66% | 78% |
| 평가자 점수(5점 만점) | 4.19 | 4.59 |
| 성공 1건당 비용 | 기준 | 약 4.3배 |
작업 종류별 성공률은 다음과 같습니다.
| 작업 종류 | Haiku 4.5 | Sonnet 4.6 |
|---|---|---|
| 스킬 적용 | 26% | 80% |
| 문서 편집 | 66% | 77% |
| 커넥터 | 50% | 100% |
| RAG 검색 | 83% | 83% |
| 여러 턴 대화 | 83% | 83% |
| 비용 함정 회피 | 80% | 80% |
| 메모리 | 60% | 60% |
결론: 스킬을 따르거나 문서를 여러 단계로 고치는 작업은 Sonnet이 필요합니다. 검색·요약·조회 중심 작업은 더 저렴한 모델로 충분합니다.
이 평가는 Claude Haiku 4.5와 Sonnet 4.6만 비교했으며(2026년 7월), GPT 계열과 Opus는 같은 조건으로 측정하지 않았습니다. 위 추천에서 GPT 계열과 Opus에 대한 내용은 가격·컨텍스트 같은 사양과 Specify 내부 기본값을 근거로 합니다.
Specify 내부 기본값
Specify가 백그라운드에서 직접 모델을 고를 때도 같은 원칙을 따릅니다.
| 작업 | 기본 모델 |
|---|---|
| 문서 유지·갱신, 계획 수립 | Claude Sonnet 4.6 |
| 자료 조사, 결과 종합, 분석 | Claude Haiku 4.5 |
| 문서 품질 개요 설계·검증 | Claude Opus 4.6 |
| 문서 자동화(워크스페이스 설정이 없을 때) | GPT-6 Luna |
사고 강도 고르기
- 끄기 — 검색·요약·짧은 답변. 가장 빠릅니다.
- 낮음 · 보통 — 문서 작성과 편집, 여러 자료를 비교하는 질문.
- 높음 이상 — 설계 결정, 복잡한 원인 분석처럼 정답을 찾기 어려운 문제. 응답이 느려지고 사용량이 크게 늘어납니다.
워크스페이스 기본 모델 정하기
자동화와 문서 생성은 채팅과 별도로 워크스페이스 설정의 모델을 사용합니다.
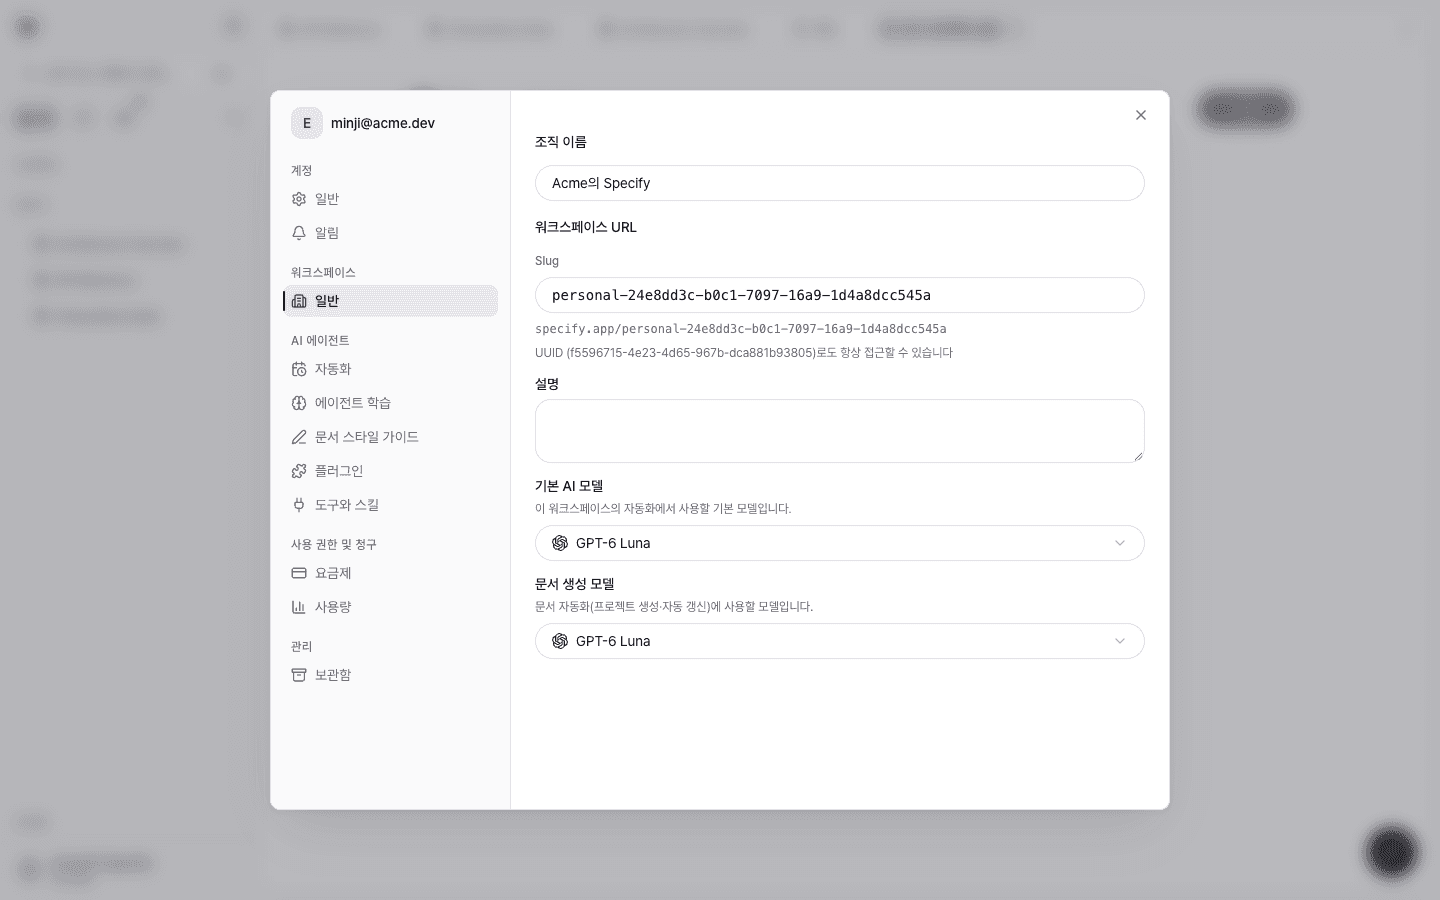
- 기본 AI 모델 — 주간 요약처럼 가벼운 자동화가 많다면 GPT-6 Luna, 문서를 고치는 자동화가 많다면 Claude Sonnet 4.6을 권장합니다.
- 문서 생성 모델 — 문서 품질이 중요하다면 Claude Sonnet 4.6을 권장합니다. 비용을 우선한다면 기본값(GPT-6 Luna)으로 시작한 뒤 결과를 보고 바꾸세요.